Uso do particionamento em tabelas no Oracle
Postado por Adauto Santos
O particionamento de tabelas é um recurso do Oracle que permite a decomposição dos dados presentes nos objetos em partes menores e mais gerenciáveis chamadas partições. A Tabela Particionada possui os mesmos atributos lógicos que uma tabela comum: constraints, tipos de dados e definições de coluna.
A tabela ou índice é particionado em nível físico no arquivo de dados, logo, não é necessário realizar qualquer alteração nos comandos DML já existentes na aplicação, tornando o particionamento completamente transparente para as aplicações.
Com o particionamento os dados podem ser consultados em unidades de discos separadas, garantindo uma performance a nível de hardware, pois um dado pode ser acessado de maneira muito mais performática diretamente em uma porção de informação menor, ao invés de se consultar um datafile completo.
Por exemplo, uma tabela com os dados de vendas dos últimos 10 anos, pode ser particionada em 10 tablespaces diferentes para representar cada ano separadamente ou ainda o ano atual pode ser separado em 4 tablespaces, com cada tablespace representando um trimestre do ano.
O gerenciamento e a disponibilidade também são melhorados para os diversos tipos de aplicações, que envolvem grande quantidade de dados, porque, a carga de informações via SQL*Loader, a criação e reconstrução de índices e o backup/recuperação são mais rápidos em arquivo menores do que em uma tabela inteira, ademais, os administradores de bancos de dados podem desativar determinados arquivos de dados e deixar que outros funcionem normalmente, logo, a aplicação não precisa estar completamente fora do ar para manutenções em determinadas tablespaces.
Existem cinco formas para o particionamento de tablespaces: lista, hash, faixa, faixa/lista e faixa/hash. No particionamento por lista, os valores são divididos em listas de valores através do operador IN (), no particionamento hash os registros valores são divididos por meio de chaves hash geradas e no particionamento por faixa as informações são divididas utilizando operadores >= ou <=, geralmente usados para manipulação de datas. Por fim, os particionamento faixa/lista e faixa/hash são combinações dos três primeiros métodos.
No presente artigo objeto de estudo são os particionamentos por lista e por faixa de valores.
Tabelas Particionadas por Lista
Para representar o particionamento por lista utilizaremos o exemplo da tabela CLIENTE, sendo que a divisão será realizado por Unidades Federativas, como segue.
CREATE TABLE CLIENTE_PARTITION
(
SEQ NUMBER(11),
NOME VARCHAR2(70),
EMAIL VARCHAR2(100),
SG_UF CHAR(2)
)
PARTITION BY LIST (SG_UF)
(
PARTITION P_NORTE VALUES ('AC','AM','AP','PA','RO','RR','TO') TABLESPACE TBS_NORTE,
PARTITION P_NORDESTE VALUES ('AL','BA','CE','MA','PB','PE','PI','RN','SE') TABLESPACE TBS_NORDESTE,
PARTITION P_CENTROOESTE VALUES ('DF','GO','MT','MS') TABLESPACE TBS_CENTROOESTE,
PARTITION P_SUDESTE VALUES ('ES','MG','RJ','SP') TABLESPACE TBS_SUDESTE,
PARTITION P_SUL VALUES ('PR','RS','SC') TABLESPACE TBS_SUL
);
Note, que cada UF foi agrupada na sua respectiva região geográfica. Talvez, em um mundo real essa separação não faça muito sentido, mas a utilizei para fins didáticos.
Os dados podem ser selecionados como o comando que se segue:
SELECT * FROM CLIENTE PARTITION (P_NORDESTE);
Para consultar as partições que compõem uma tabela pode-se consultar a DBA_TAB_PARTITIONS, como no comando que se segue.
SQL> SELECT TABLE_NAME, PARTITION_NAME, TABLESPACE_NAME
       FROM DBA_TAB_PARTITIONS
      WHERE TABLE_NAME='CLIENTE_PARTITION';

TABLE_NAME                     PARTITION_NAME                 TABLESPACE_NAME
------------------------------ ------------------------------ ------------------------------
CLIENTE_PARTITION              P_CENTROOESTE                  TBS_CENTROOESTE
CLIENTE_PARTITION              P_NORDESTE                     TBS_NORDESTE
CLIENTE_PARTITION              P_NORTE                        TBS_NORTE
CLIENTE_PARTITION              P_SUDESTE                      TBS_SUDESTE
CLIENTE_PARTITION              P_SUL                          TBS_SUL
Meus testes
Para demonstrar o ganho de performance proporcionado pelo uso do particionamento de tabelas, serão apresentados três exemplos com a tabela da sessão anterior e possuindo respectivamente 100 mil, 1 milhão e 5 milhões de registros, sendo qua a distribuição de UF x registro foi uniforme. A consulta apenas realiza a contagem da quantidade de registros dos estados de PR, SC e RS agrupando-os.
Teste 1 - 100.000 registros
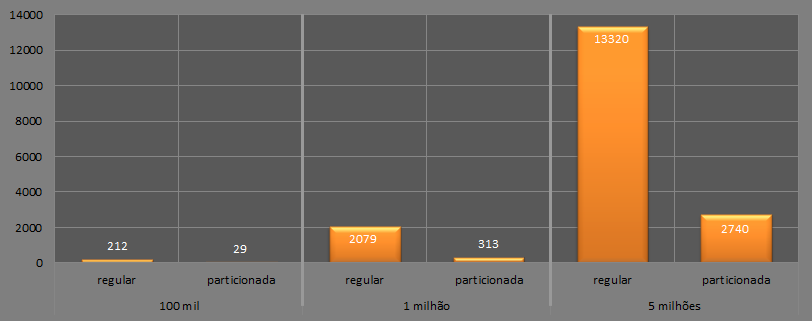
A seguir, podem ser observados os planos de execução da tabela normal (CLIENTE_100K_REG) e da tabela particionada (CLIENTE_100K). Observe que nesse caso a tabela normal teve um custo de 212 enquanto a tabela particionada teve um custo de 29, logo, a tabela normal teve um custo melhor que a tabela particionada.
SQL> SELECT SG_UF, COUNT(*) FROM < NOME_TABELA > WHERE SG_UF IN ('PR','SC','RS') GROUP BY SG_UF;

-- Tabela Normal/Regular
---------------------------------------------------------------------------------------
| Id  | Operation	   | Name	      | Rows  | Bytes | Cost (%CPU)| Time     |
---------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |		      | 11460 | 45840 |   212	(2)| 00:00:03 |
|   1 |  HASH GROUP BY	   |		      | 11460 | 45840 |   212	(2)| 00:00:03 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_100K_REG | 11460 | 45840 |   211	(1)| 00:00:03 |
---------------------------------------------------------------------------------------

-- Tabela Particionada
------------------------------------------------------------------------------------------------------
| Id  | Operation	      | Name	     | Rows  | Bytes | Cost (%CPU)| Time     | Pstart| Pstop |
------------------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT      | 	     | 12436 | 49744 |	  29   (7)| 00:00:01 |	     |	     |
|   1 |  PARTITION LIST INLIST| 	     | 12436 | 49744 |	  29   (7)| 00:00:01 |KEY(I) |KEY(I) |
|   2 |   HASH GROUP BY       | 	     | 12436 | 49744 |	  29   (7)| 00:00:01 |	     |	     |
|   3 |    TABLE ACCESS FULL  | CLIENTE_100K | 12436 | 49744 |	  28   (4)| 00:00:01 |KEY(I) |KEY(I) |
------------------------------------------------------------------------------------------------------
Teste 2 - 1.000.000 registros
Na sequência pode-se observar os planos de execução das tabelas normal e particionada que possuem 1 milhão de registros. Nesse caso a tabela particionada apresentou um custo 313 e a tabela regular 2.079, sendo assim uma diferença bem significativa.
-- Tabela Normal/Regular
-------------------------------------------------------------------------------------
| Id  | Operation	   | Name	    | Rows  | Bytes | Cost (%CPU)| Time     |
-------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |		    | 97663 |	381K|  2079   (1)| 00:00:25 |
|   1 |  HASH GROUP BY	   |		    | 97663 |	381K|  2079   (1)| 00:00:25 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_1M_REG | 97663 |	381K|  2076   (1)| 00:00:25 |
-------------------------------------------------------------------------------------

-- Tabela Particionada
----------------------------------------------------------------------------------------------------
| Id  | Operation	      | Name	   | Rows  | Bytes | Cost (%CPU)| Time     | Pstart| Pstop |
----------------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT      | 	   |   112K|   438K|   313  (24)| 00:00:04 |	   |	   |
|   1 |  PARTITION LIST INLIST| 	   |   112K|   438K|   313  (24)| 00:00:04 |KEY(I) |KEY(I) |
|   2 |   HASH GROUP BY       | 	   |   112K|   438K|   313  (24)| 00:00:04 |	   |	   |
|   3 |    TABLE ACCESS FULL  | CLIENTE_1M |   112K|   438K|   309  (23)| 00:00:04 |KEY(I) |KEY(I) |
----------------------------------------------------------------------------------------------------
Teste 3 - 5.00.000 registros
Em seguida, são observadas a comparação das tabelas com 5 milhões de registros. Nessa comparação constata-se que o custo da tabela particionada foi de 2.740 enquanto a tabela regular foi de 13.320.
-- Tabela Normal/Regular
--------------------------------------------------------------------------------------
| Id  | Operation	   | Name	     | Rows  | Bytes | Cost (%CPU)| Time     |
--------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |		     |	 209K|	 817K| 13320   (1)| 00:02:40 |
|   1 |  HASH GROUP BY	   |		     |	 209K|	 817K| 13320   (1)| 00:02:40 |
|*  2 |   TABLE ACCESS FULL| CLIENTE_5M_REG |	 209K|	 817K| 13314   (1)| 00:02:40 |
--------------------------------------------------------------------------------------

-- Tabela Particionada
-----------------------------------------------------------------------------------------------------
| Id  | Operation	      | Name	    | Rows  | Bytes | Cost (%CPU)| Time     | Pstart| Pstop |
-----------------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT      | 	    |	533K|  2084K|  2740  (59)| 00:00:33 |	    |	    |
|   1 |  PARTITION LIST INLIST| 	    |	533K|  2084K|  2740  (59)| 00:00:33 |KEY(I) |KEY(I) |
|   2 |   HASH GROUP BY       | 	    |	533K|  2084K|  2740  (59)| 00:00:33 |	    |	    |
|   3 |    TABLE ACCESS FULL  | CLIENTE_5M |	533K|  2084K|  2724  (59)| 00:00:33 |KEY(I) |KEY(I) |
-----------------------------------------------------------------------------------------------------
Em todos os cenários as tabelas particionadas foram melhores que as tabelas regulares, com larga vantagem. O gráfico a seguir ilustra os custos obtidos nas consultas.
Para finalizar, a tabela a seguir resume as estatísticas dos cenários avaliados.
| Descrição | 100 mil regs. | 1 milhão regs. | 5 milhões regs. | |||
| Normal | Partic. | Regular | Partic. | Regular | Partic. | |
| recursive calls | 0 | 0 | 0 | 0 | 5 | 5 |
| db block gets | 0 | 0 | 0 | 0 | 0 | 0 |
| consistent gets | 769 | 99 | 7.600 | 869 | 87.958 | 4.220 |
| physical reads | 0 | 0 | 7.596 | 0 | 4.9074 | 0 |
| redo size | 0 | 0 | 0 | 0 | 3.456 | 0 |
| bytes sent via SQL*Net to client | 663 | 663 | 665 | 665 | 670 | 665 |
| bytes received via SQL*Net from client | 523 | 523 | 523 | 523 | 523 | 523 |
| SQL*Net roundtrips to/from client | 2 | 2 | 2 | 2 | 2 | 2 |
| sorts (memory) | 0 | 0 | 0 | 0 | 0 | 0 |
| sorts (disk) | 0 | 0 | 0 | 0 | 0 | 0 |
| rows processed | 3 | 3 | 3 | 3 | 3 | 3 |
Particionamento - Ressalva
De acordo com a sessão anterior o particionamento se mostrou uma solução muito eficiente. Entretanto, a consulta utilizada no teste convenientemente retornava exatamente uma única partição (P_SUL da tablespace TBS_SUL). Talvez em um ambiente de produção as consultas não tenham esse mesmo comportamento, logo, o particionamento deve estar alinhado com as regras de negócio.
No exemplo a seguir utilizou-se uma tabela de 10 milhões de registros, agrupando e contando de todas as UFs presentes. Nesse caso em especifíco o particionamento não se mostrou eficiente, piorando o custo e as demais estatísticas. Logo, o particionamento de tabelas deve ser estudado com muito cuidado e deve ser adotado e conjunto com outras práticas para a melhoria do desempenho.
SQL> SELECT SG_UF, COUNT(*) FROM < NOME_TABELA > GROUP BY SG_UF;

-- Tabela Normal/Regular
--------------------------------------------------------------------------------------
| Id  | Operation	   | Name	     | Rows  | Bytes | Cost (%CPU)| Time     |
--------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT   |		     |	9702K|	  37M| 20965   (2)| 00:04:12 |
|   1 |  HASH GROUP BY	   |		     |	9702K|	  37M| 20965   (2)| 00:04:12 |
|   2 |   TABLE ACCESS FULL| CLIENTE_10M_REG |	9702K|	  37M| 20646   (1)| 00:04:08 |
--------------------------------------------------------------------------------------

-- Tabela Particionada
---------------------------------------------------------------------------------------------------
| Id  | Operation	    | Name	  | Rows  | Bytes | Cost (%CPU)| Time  | Pstart| Pstop |
---------------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT    |		  |    12M|    47M| 21929   (3)| 00:04:24 |	  |	  |
|   1 |  PARTITION LIST ALL |		  |    12M|    47M| 21929   (3)| 00:04:24 |	1 |	5 |
|   2 |   HASH GROUP BY     |		  |    12M|    47M| 21929   (3)| 00:04:24 |	  |	  |
|   3 |    TABLE ACCESS FULL| CLIENTE_10M |    12M|    47M| 21510   (1)| 00:04:19 |	1 |	5 |
---------------------------------------------------------------------------------------------------
| Descrição | 10 milhões regs. | |
| Normal | Partic. | |
| recursive calls | 0 | 0 |
| db block gets | 0 | 0 |
| consistent gets | 75930 | 76588 |
| physical reads | 75925 | 76463 |
| redo size | 0 | 0 |
| bytes sent via SQL*Net to client | 1125 | 1114 |
| bytes received via SQL*Net from client | 534 | 534 |
| SQL*Net roundtrips to/from client | 3 | 3 |
| sorts (memory) | 0 | 0 |
| sorts (disk) | 0 | 0 |
| rows processed | 27 | 27 |
Referências
https://oracle-base.com/articles/8i/partitioned-tables-and-indexes
https://docs.oracle.com/cd/B28359_01/server.111/b32024/partition.htm
http://www.oracle.com/technetwork/pt/articles/database-performance/criando-tabelas-particionadas-3047879-ptb.html
https://docs.oracle.com/cd/B28359_01/server.111/b32024/partition.htm
https://imasters.com.br/artigo/3824/oracle/tabela-particionada/?trace=1519021197&source=single
Adauto Santos
Analista de Sistemas Senior na Unimed Regional Maringá. Formado em Informática pela Universidade Estadual de Maringá. Pós-Graduado em Administração de Banco de Dados pela Metrocamp e Business Intelligence pela Unicesumar.
WebSite: http://www.adautosantos.com.br/LinkedIn: http://www.linkedin.com/in/adauto-santos-91278029
Facebook: https://www.facebook.com/adauto.santos.946